프롬프트 체이닝
에이전트 시스템 기본기. 프롬프트 체이닝 정리
프롬프트 체이닝 (에이전트의 분할정복 패턴)
큰 문제를 한번에 해결하는 어렵습니다. 하나의 문제를 여러가지 하위 요소로 분리하여 하나씩 해결해나가는게 알고리즘의 기초이듯, 대부분의 복잡한 문제 풀이는 분할 정복(Divide and Conquer)의 형태를 따릅니다. 프롬프트 체이닝은 이 요소를 다루는 에이전트 디자인 패턴의 가장 기초적인 패턴입니다.
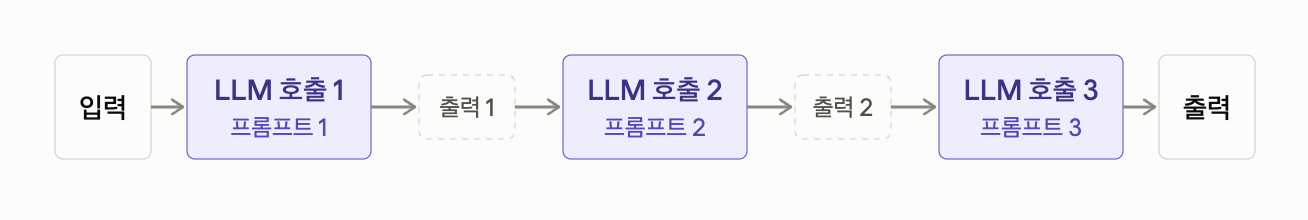
프롬프트 체이닝 기법은 문제를 풀기 위해 각 단계를 분할하고 LLM에게 해결을 위임합니다. 사실 이 방식은 아래 세 단계로 이루어지는 굉장히 원시적인 방법입니다.
- 문제를 해결할 각 단계를 분할한다.
- 단계별로 분할된 문제 덩어리에 대한 프롬프트를 생성한다
- 그 프롬프트들을 연결해서 최종적으로 문제를 해결한다.
프롬프트가 체인처럼 이어진 성질 때문에 파이프라인 패턴(Pipeline pattern)이라고도 불립니다. 함수형 프로그래밍과 유사하네요.
순차적 분해를 통한 신뢰성 향상
프롬프트 체이닝은 복잡한 작업을 명확한 순차 워크플로우로 분해하여 문제를 해결합니다. 문제를 분해해서 각 단계별로 프롬프트 워크플로우를 작성하기 때문에 각 프롬프트 별 신뢰성과 제어 가능성이 크게 높아지지요. 만약 에이전트에 아래와 같은 업무를 맡긴다고 가정해봅시다.
- 시장 보고서 핵심 요소 요약
- 시장 트렌드 식별
- 다음 트렌드 정리 및 마케팅 팀 이메일 작성
만약 단일 프롬프트로 위 단계를 모두 진행하려고 한다면 어떤 결과가 발생할까요? 시장 보고서 요약 중 발생하는 컨텍스트 폭발, 트렌트 취합 지시 누락 발생, 정리 및 마케팅 팀 이메일 작성 시 뭔가 꺼림칙한 상황이 발생하는 등 다소 통일되지 않은 결과가 나올 것으로 보입니다.
실제로 회사 보고서 관련 에이전트를 개발했을 때 보고서 데이터 취합과 문체 정리, 앞으로 발생할 문제들 예측 등을 모두 하나의 프롬프트로 했었습니다. LLM이 좋아져서 충분히 감내가 될 줄 알았는데, 실제로는 읽기는 편하더라도 내용이나 문체 통일이 잘 되지 않는 산출물이 탄생했습니다. 모델이 좋아지더라도 지킬 것은 지켜야 낭비를 막을 수 있겠습니다.
그럼 저 문제를 아래와 같이 순차적으로 분해해봅시다.
- 첫 번째 프롬프트(요약) : 다음 시장 조사 보고서의 핵심 결과를 요약하라. - 모델은 요약에만 집중하므로 초기 단계의 정확성이 높아집니다.
- 두 번쨰 프롬프트(트렌드 식별) : 요약을 바탕으로 세가지 신흥 트렌드를 식별하고, 각 트렌드를 뒷받침하는 구체적인 데이터 포인트를 추출하라. - 이미 검증된 1단계 출력에서 작업이 진행되기 때문에 단일 프롬프트로 트렌드 식별을 하는 것 보다 더 신뢰할 수 있는 출력물을 받을 가능성이 높아집니다.
- 세 번째 프롬프트(이메일 작성) : 다음 트렌드와 이를 뒷받침하는 데이터를 정리하여 마케팅 팀에 보낼 간결한 이메일을 작성하라 - 이미 정리되어 있는 값들을 바탕으로 마케팅팀에 전달할 이메일을 작성하므로, 두 번쨰 프롬프트와 마찬가지로 이전보다 더 신뢰할 수 있는 출력물을 받을 가능성이 높아집니다.
단일 프롬프트 대비 프롬프트 체이닝의 장점은 프로세스를 더 세밀하게 제어할 수 있다는 것입니다. 각 프롬프트에 적혀진 태스크를 마친 후 산출된 출력물을 다음 프롬프트에 제공하는 형식으로 동작하기 때문에 프롬프트 별 모호성도 적어지고, 모듈성도 높아집니다.
구조화된 출력 사용
프롬프트 체이닝의 신뢰성은 각 프롬프트 사이에 전달되는 데이터가 얼마나 온전히 남아있느냐에 좌우됩니다. 프롬프트의 출력이 모호한 형태로 나오거나, 형식이 불량하면 프롬프트는 잘못된 입력을 가지고 다음 태스크를 수행하기 때문에 실패된 결과가 연속적으로 체이닝되어 불량한 결과가 출력됩니다.
이를 줄이려면 프롬프트 체이닝에서는 JSON이나 XML같은 구조화된 출력 형식을 지정하는 것이 중요합니다. 예를 들어 트렌드 식별 단계의 출력은 아래와 같은 JSON 객체로 만들 수 있습니다.
{
  "trends": [
    {
      "name": "생성형 AI 기반 개인화 마케팅 확산",
      "summary": "마케팅 조직의 생성형 AI 도입이 빠르게 늘면서, 고객별 맞춤 콘텐츠 제작이 표준 업무로 자리잡고 있다.",
      "evidence": [
        { "metric": "마케팅 조직 생성형 AI 도입률", "value": "35% → 58%", "period": "2024 → 2025", "source": "요약 2.1" },
        { "metric": "개인화 캠페인 전환율 (일반 캠페인 대비)", "value": "1.7배", "period": "2025", "source": "요약 2.3" }
      ]
    },
    {
      "name": "숏폼 영상 커머스 성장",
      "summary": "숏폼 영상이 탐색 채널을 넘어 구매 채널로 확장되고 있다.",
      "evidence": [
        { "metric": "숏폼 경유 구매 비중", "value": "12% → 24%", "period": "2024 → 2025", "source": "요약 3.1" }
      ]
    },
    {
      "name": "제로파티 데이터 수집 강화",
      "summary": "서드파티 쿠키 축소에 대응해 고객이 직접 제공하는 데이터 확보에 투자가 몰리고 있다.",
      "evidence": [
        { "metric": "서드파티 쿠키 의존도 축소 계획 기업 비율", "value": "71%", "period": "2025", "source": "요약 4.2" }
      ]
    }
  ]
}
이렇게 구조화된 형식을 사용하면 LLM이 데이터를 쉽게 읽을 수 있게 됩니다. 텍스트의 모호함 없이 다음 프롬프트에 안정적으로 소화시킬 수 있는 데이터 타입을 받게 되는 것이죠. 이러한 포맷 맞추기는 견고한 다단계 LLM 기반 시스템을 구축하는데 핵심 요소가 됩니다.
실사용 예시: 광고 카피 자산화
그렇다면 프롬프트 체이닝을 어떻게 실전에 사용할 수 있을까요? 실전 예시를 정리해보겠습니다.
멀티모달 처리 체인 설계
- 멀티모달 : 이미지, 영상, 텍스트와 같이 서로 다른 타입의 데이터를 동시에 인식하고 처리하는 기술
다양한 모달리티를 가진 데이터를 분석할 때도 문제를 더 작은 프롬프트 단위로 분해하는 것이 효과적입니다. 예를 들어 광고 이미지에서 카피를 추출하고, 우리 회사에 맞는 자산이면 저장하고 아니면 저장하지 않는 작업을 에이전트에 맡긴다고 가정해봅시다. 이 작업은 아래와 같이 세 단계로 나눌 수 있습니다.
- 프롬프트1(추출) : 이미지에 포함된 카피를 역할(헤드라인, 서브카피, CTA)별로 원문 그대로 추출하여 JSON으로 출력하라. 해석은 하지 않는다. - 모델이 이미지에서 텍스트를 읽어내는 데만 집중하므로 추출 정확도가 높아집니다.
- 프롬프트2(판정) : 추출된 카피가 회사 자산 기준에 맞는지 판정하고, 저장 여부(save/skip)와 그 사유를 JSON으로 출력하라. - 이미지가 아닌 정리된 텍스트를 보고 판단하기 때문에 기준에 맞춰 일관되게 판정할 수 있습니다.
- 프롬프트3(해석·저장) : save로 판정된 카피의 소구점, 타깃, 활용 맥락을 해석하여 저장 양식에 맞춰 기술하라. - 프롬프트2가 save로 판정한 경우에만 실행되고, skip이면 체인은 여기서 종료됩니다.
각 단계의 출력은 아래와 같은 형태로 다음 프롬프트에 전달됩니다. 먼저 프롬프트1은 이미지에서 읽어낸 카피를 역할별로 정리합니다.
{
  "image_id": "banner_001",
  "copies": [
    { "role": "headline", "text": "판매는 오늘, 정산도 오늘" },
    { "role": "sub", "text": "판매 대금, 이제 기다리지 마세요" },
    { "role": "cta", "text": "지금 한도 조회하기" }
  ]
}
프롬프트2는 이 결과를 받아 저장 여부를 판정합니다. 판정 기준은 회사마다 다르겠지만, 여기서는 서비스 관련성, 브랜드 톤, 규제 표현 준수 세 가지로 잡았습니다.
{
  "image_id": "banner_001",
  "decision": "save",
  "checks": { "service_relevance": true, "brand_tone": true, "compliance": true },
  "reason": "서비스 핵심 가치(빠른 정산)를 직접 소구하며, 금지 표현이 없음"
}
마지막으로 프롬프트3은 save로 판정된 카피만 해석하여 저장 양식에 맞춰 기록합니다.
{
  "image_id": "banner_001",
  "copies": ["판매는 오늘, 정산도 오늘", "판매 대금, 이제 기다리지 마세요", "지금 한도 조회하기"],
  "interpretation": {
    "appeal": "자금 회전 속도",
    "target": "정산 주기가 길어 현금 흐름이 막히는 온라인 셀러",
    "usage": "퍼포먼스 광고 헤드라인"
  }
}
만약 하나의 프롬프트로 추출, 판정, 해석을 모두 진행한다면 판정과 해석이 한 번에 섞이면서 판정 기준이 흐려질 수 있습니다.
코드 예시
위 체인을 Claude SDK(TypeScript)로 구현하면 아래와 같습니다. 핵심인 프롬프트에 집중하기 위해 저장 로직은 생략했습니다.
import Anthropic from "@anthropic-ai/sdk";
import { readFileSync } from "node:fs";

const client = new Anthropic(); // ANTHROPIC_API_KEY 환경변수를 읽음

async function ask(content: Anthropic.MessageParam["content"]) {
  const res = await client.messages.create({
    model: "claude-sonnet-5-5",
    max_tokens: 1024,
    messages: [{ role: "user", content }],
  });
  const block = res.content[0];
  if (block.type !== "text") throw new Error("텍스트 응답 없음");
  return JSON.parse(block.text);
}

// 프롬프트1(추출): 이미지 → 카피 JSON
async function extract(imagePath: string) {
  const data = readFileSync(imagePath).toString("base64");
  return ask([
    { type: "image", source: { type: "base64", media_type: "image/png", data } },
    {
      type: "text",
      text: `이미지에 포함된 카피를 역할(headline, sub, cta)별로 원문 그대로 추출하라.
해석은 하지 않는다. 아래 JSON 형식으로만 출력하라.
{"copies": [{"role": "headline" | "sub" | "cta", "text": string}]}`,
    },
  ]);
}

// 프롬프트2(판정): 카피 JSON → save/skip
async function judge(extracted: unknown) {
  return ask(`다음 카피가 회사 자산 기준에 맞는지 판정하라.
기준: 서비스 관련성, 브랜드 톤, 규제 표현 준수
아래 JSON 형식으로만 출력하라.
{"decision": "save" | "skip", "checks": {"service_relevance": boolean, "brand_tone": boolean, "compliance": boolean}, "reason": string}

카피: ${JSON.stringify(extracted)}`);
}

// 프롬프트3(해석): save로 판정된 카피만
async function interpret(extracted: unknown) {
  return ask(`다음 카피의 소구점, 타깃, 활용 맥락을 해석하라.
아래 JSON 형식으로만 출력하라.
{"interpretation": {"appeal": string, "target": string, "usage": string}}

카피: ${JSON.stringify(extracted)}`);
}

async function run(imagePath: string) {
  const extracted = await extract(imagePath);
  const judged = await judge(extracted);
  if (judged.decision !== "save") {
    return { saved: false, reason: judged.reason }; // 게이트: skip 사유를 남기고 종료
  }

  const { interpretation } = await interpret(extracted);
  return { saved: true, ...extracted, interpretation }; // 이 결과를 저장소에 저장
}

run("./banner_001.png").then(console.log);
결론
프롬프트 체이닝은 복잡한 문제를 단순하고 관리 가능한 하위 작업으로 분해해, LLM이 한 번에 하나의 문제만 풀도록 안내하는 패턴입니다. 덕분에 단일 프롬프트보다 신뢰할 수 있는 산출물을 받기 쉬워집니다.
다만 처음에 말씀드린 것처럼, 이 패턴은 문제를 어떻게 나눌지 미리 알고 있을 때 쓰는 방식입니다. 입력에 따라 거쳐야 할 단계가 달라지는 문제라면 고정된 체인으로는 대응하기 어렵습니다. 또 단계마다 LLM을 호출하므로 비용과 응답 시간이 늘어난다는 점도 감안해야 합니다.
그럼에도 복잡한 에이전틱 시스템은 결국 작은 단계들의 연결 위에 만들어집니다. 그런 의미에서 프롬프트 체이닝은 가장 먼저 익혀야 할 기본 패턴입니다.
댓글
아직 댓글이 없습니다.